fullseye
言語 / Language: 日本語 · English(準備中)
検査 52 件を全部緑にしてから、規格の答えと突き合わせたら 5 件落ちた —— 測る側を測る話
自作の画像計測ライブラリ Fullseye に、測定システム解析(ゲージ R&R)と測定の不確かさ(GUM) の 9 つの演算子を足しました。
いつもどおり、実装する前に採点の仕方を決めました。この repo の規律は「定理が門になるか、既存の別実装が真値になるか」で、使った式でそのまま答え合わせをする検査は書きません。その方針で恒等式・閉形式・対照群から検査を 52 件組み、全部緑にしました。
そのあとで、規格に載っている worked example の公表値と突き合わせました。
5 件落ちました。合成データの検査は 1 件も落ちていないのに。
この記事は、その 5 件が何だったのか、なぜ合成の検査では原理的に見つからないのか、そして「道具が正しく失敗する」ことをどう設計に入れたか、の話です。
TL;DR
- 恒等式・閉形式・対照群で作った検査 52 件が全部緑の状態から、規格の公表値と突き合わせて 5 件の欠陥が出た
- 5 件とも「仕様の不在」だった —— あるべき経路が無い / 手順の順序が違う / 主張の範囲が広すぎる
- 自分が書いた仕様どおりに動くかしか見られない合成の検査には、仕様の外側は原理的に映らない
- 特に効いたのは 厳密解(4 つの一様分布の和 = Irwin–Hall)—— 同じ「検証に落ちた」でも原因が逆だと証明できた
- 伝播則が破綻する場所では
u = 0が返る。これは実装の誤りではなく手法の限界なので、警告ではなく構造で申告する設計にした
1. そもそも何を測る話か
工場の検査ラインで「この寸法のばらつきは 0.3 mm です」と言うとき、その 0.3 mm の中に測定器のばらつきが混ざっています。管理図も工程能力指数も、混ざったままの数字を見ています。
分けるのがゲージ R&R です。総変動を
- 繰り返し性(同じ人が同じ物を測り直したときの散らばり)
- 再現性(人が変わったときの散らばり)
- 部品間(本当に見たいもの)
に分解して、「測る行為」が「見たいもの」を食っていないかを見ます。
もう一方の GUM(測定における不確かさの表現のガイド)は、同じ問いを1 回の測定について立てます。温度の補正、校正証明書の値、読み取りの量子化 —— 成分を並べて合成し、「この測定値は ±U です」と報告できる形にする。
どちらも閉形式の規格モデルで、照合できる厳密な恒等式を持っています。だから Fullseye に入れる条件を満たします。
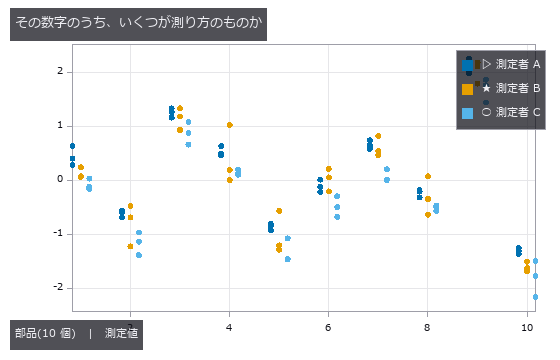
↑ 規格の例題(10 部品 × 3 測定者 × 3 回 = 90 点)を、部品ごとに縦に並べたもの。塊が縦に離れている幅が部品どうしの差(総変動の 92.2 %)、各塊の太さが同じ部品を測り直したときのばらつき(7.8 %)。測定器が使えるかは、この 2 つの比で決まる。
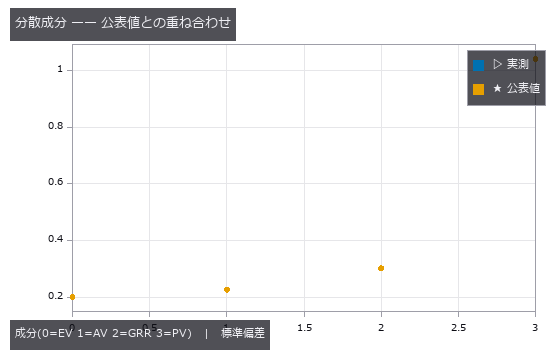
↑ 規格の例題(10 部品 × 3 測定者 × 3 回 = 90 点)の分散成分。実測と公表値が重なっている。測る行為(GRR)が総変動に占めるのは 7.8 %、部品どうしの差が 92.2 %。
2. 合成データで組んだ 52 件の検査
実装前に決めた採点の出どころは 3 つだけです。
(a) 代数的な恒等式
分散分析の平方和は
SS_total = SS_部品 + SS_測定者 + SS_交互作用 + SS_誤差
で必ず閉じます。これは分解の代数そのものなので、分散成分をどう導こうと成り立つ。つまり推定の正しさとは別の層で実装を押さえられます。実測の相対差は 1e-16。
(b) 既存の別実装が真値になる
繰り返し性 var_repeat = MS_err は、釣り合った計画では「各升目の np.var(ddof=1) の平均」に代数的に等しい。導出も実装も別なので、片方が壊れれば一致しません。
cells = values.reshape(10, 3, 3)
by_cell = np.array([[np.var(cells[i, j], ddof=1) for j in range(3)] for i in range(10)])
assert abs(ev ** 2 - by_cell.mean()) < 1e-12 * by_cell.mean()   # 通る
(c) 構成上、答えを知っているデータ
偏り a + b·基準値 を雑音 0 で仕込めば、最小二乗は a と b を 1e-15 まで厳密に取り戻すはずです。
この 3 つで 52 件。全部緑。ここで止めていたら、次の 5 件は永久に見つかりませんでした。
3. 落ちた 5 件
① 交互作用を畳む経路が、そもそも無かった
規格の例題を通したら、繰り返し性が 0.214435。公表値は 0.199933。7.3 % ずれる。
原因は計算の誤りではありませんでした。規格の手順は
交互作用の F 検定が有意でなければ、交互作用項を落として再計算する
で、この例題は F = 0.434 / p = 0.9741 と交互作用がまったく効いていないため、畳んだ値が公表されています。私の実装には畳む経路が無く、常に交互作用を残していました。
畳んで計算し直したら:
| 実測 | 公表 | 差 | |
|---|---|---|---|
| 繰り返し性 EV | 0.199933 | 0.199933 | 1.8e-07 |
| 再現性 AV | 0.226838 | 0.226838 | 4.8e-07 |
| 合成 GRR | 0.302372 | 0.302373 | 1.5e-06 |
| 部品 PV | 1.042327 | 1.042327 | 4.9e-07 |
| 寄与率 | 3.4 / 4.4 / 7.8 / 92.2 % | 同左 | 完全一致 |
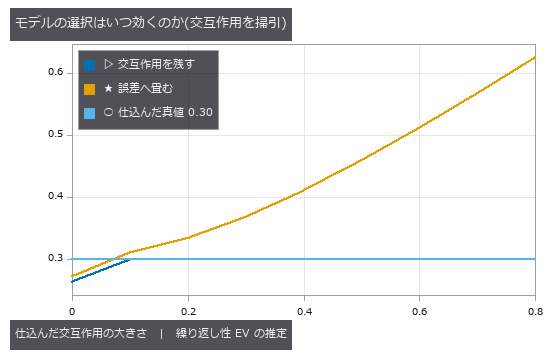
↑ 同じ 90 点のデータで、交互作用を残すか畳むかだけで EV が 7.3 % 動く。
ここで設計を 1 つ変えました。 モデルの選択が答えを動かすなら、どちらを使ったかを結果に載せる。
g = fs.ledger.msa_gauge_rr(table)
g["interaction_pooled"]   # True / False
g["interaction_p"]        # 0.9741
g["pool_alpha"]           # 0.25
黙って切り替えると、同じ道具が同じ工程について別の数字を返し、理由が出力のどこにも残りません。
なお閾値の 0.25 は規格が明記した数ではありません。本文が言うのは「交互作用を見落とす危険を下げるため高い有意水準を選べ」という定性的な指示だけで、0.25 はソフトウェア慣行の多数派です(別の実装は 0.05 を既定にしています)。例題の表は脚注で α=0.05 を宣言しているので、表の再現を名乗る検査は 0.05 を明示して通すようにしました —— 既定値の妥当性と、公表例題の再現条件は、別の話です。
② 有効自由度を、切り捨てずに t 表を引いていた
端度器の校正例で、包含係数 k が 2.1132。公表は 2.12。
規格は「有効自由度が整数でなければ、t 表を引く直前に次に小さい整数へ切り捨てる」と要求しています。ν_eff = 16.64 をそのまま引くと 2.1132、16 に切り捨ててから引くと 2.1199。
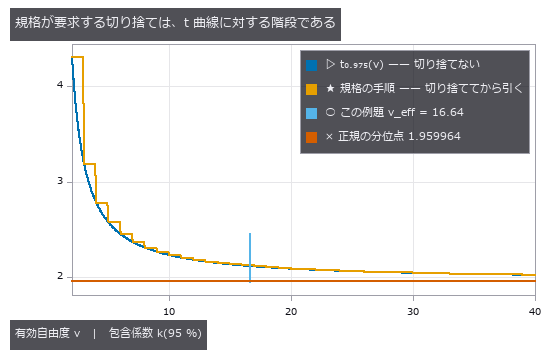
↑ 有効自由度は整数とは限らないので、規格は次に小さい整数へ切り捨ててから t 表を引けと定めます(安全側へ倒すため)。滑らかな t₀.₉₇₅(ν) に対して、規格の手順は階段になります。ν → ∞ ではどちらも正規の 1.959964 に収束します。
t 分布の実装は両方正しく、違うのは手順の順序だけでした。この診断ができたのは、公表値が中間結果(ν_eff = 16.7)も出していたからです。
不確かさの予算そのものも再現しました:
| 成分 | 実測(nm) | 公表(nm) |
|---|---|---|
| 標準器 | 25 | 25 |
| 読み取り平均 | 5.8 | 5.8 |
| 比較器 ① | 3.9 | 3.9 |
| 比較器 ② | 6.7 | 6.7 |
| 熱膨張係数差 | 2.9 | 2.9 |
| 温度差 | 16.68 | 16.6 |
後ろ 2 つは入力の単位が 1/°C と °C なので、感度係数を掛けて初めて nm になります。ここが合っているということは、感度係数の扱いまで含めて正しいということです。
③ docstring に書いた主張が、偽だった
私は gum_propagate の説明にこう書いていました。
独立でない量を独立として扱うと不確かさを過小に見積もる
よく言われる話です。そして偽でした。
電圧・電流・位相差から抵抗とリアクタンスを同時に出す例(3 量すべてに相関がある)で、相関行列を落として測ると:
| 相関あり | 相関なし | ||
|---|---|---|---|
抵抗 u_c(R) |
0.0702 | 0.1945 | 2.8 倍の過大 |
リアクタンス u_c(X) |
0.2961 | 0.2009 | 過小 |
インピーダンス u_c(Z) |
0.2367 | 0.2041 | 過小 |
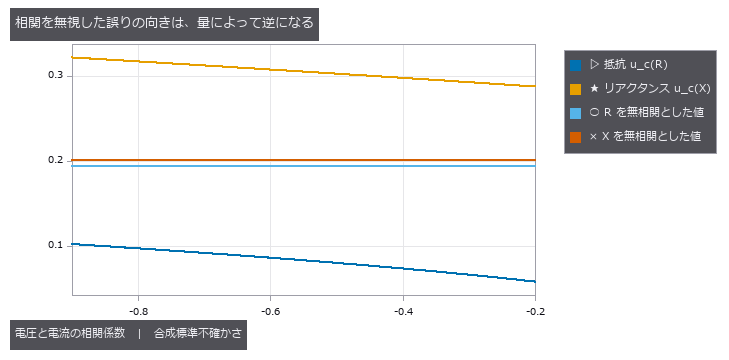
↑ 同じ 1 組の観測から 3 つの量を出している。相関を落とすと、量によって向きが逆に出る。
同じ 1 つのデータで、量によって向きが逆に出ます。 感度係数の符号と相関の符号の積で決まるので、当たり前といえば当たり前なのですが、「安全側に外れるから省いてよい」という判断は、抵抗については3 倍近く過大な不確かさを報告することになります。
docstring を実測ごと書き直しました。自分が書いた説明文が、規格の例題に否定されたという形の欠陥です。
④ モンテカルロが線形専用で、それが存在する理由を示せなかった
GUM には補遺 1 があり、モンテカルロで分布そのものを伝播させます。なぜそんなものが要るのか —— 伝播則(1 次近似)が通用しない場面があるからです。
ところが私の gum_monte_carlo は y = Σ cᵢxᵢ の線形モデル専用でした。線形なら伝播則と一致するのは当たり前で、食い違う場面を再現できません。つまり「独立な検算」と名乗る資格が半分しかない状態でした。
冪の列を足して y = Σ cᵢ (xᵢ + εᵢ)^{pᵢ} まで扱えるようにしました。任意の関数を受け取らないのは、台帳に載る演算子は宣言的でなければならないからです(呼び出し可能オブジェクトは型として持てない)。それでも規格の非線形の例は表現できます。
⑤ 「位置が不安定」を、対称分布に限定していなかった
これは ⑤ 番目ですが、見つかったのは最後です。後述します。
4. 正しく失敗する
比較損失 δY = X₁² + X₂²(各 u = 0.005)を x₁ = x₂ = 0 で評価します。
感度係数は cᵢ = ∂δy/∂xᵢ = 2xᵢ なので、両方 0。伝播則は素直に
u_c = 0, 95 % 区間 = [0, 0]
を返します。入力に不確かさがあるのに、出力の不確かさがゼロ。
これは実装の誤りではありません。 1 次近似が極値で情報を全部失う、という手法そのものの限界です。同じ状況でモンテカルロは δy = 50×10⁻⁶ / u = 50×10⁻⁶ / [0, 150×10⁻⁶] を返します(公表値と一致)。
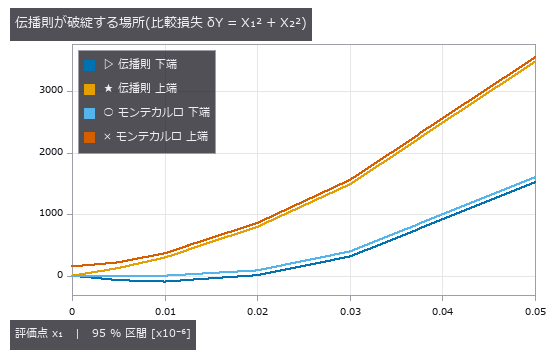
↑ 評価点を動かすと、伝播則の区間は極値付近で負の損失を含む(物理的にありえない)。離れれば両者は近づく。
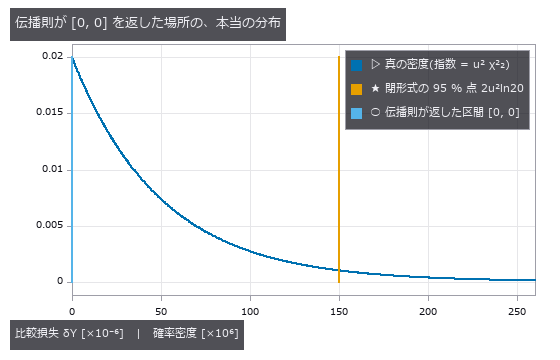
↑ x₁ = x₂ = 0 では X₁²+X₂² は u²χ²₂ = 平均 2u² の指数分布になります —— 原点に肩を持つ強く非対称な分布で、95 % 点は 2u²ln20 = 149.79×10⁻⁶ という閉形式(公表値 150 と一致)。伝播則は感度 c = 2x₁ が 0 になるので、原点の一点しか返せません。
そして、壊れ方は連続ではありません。
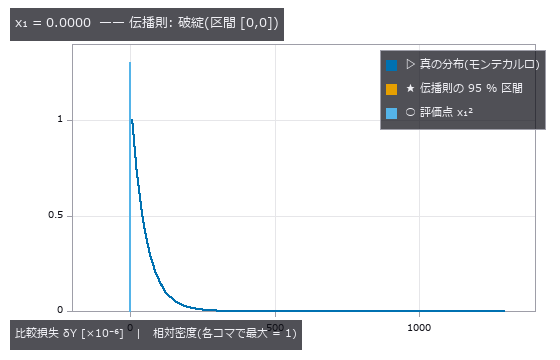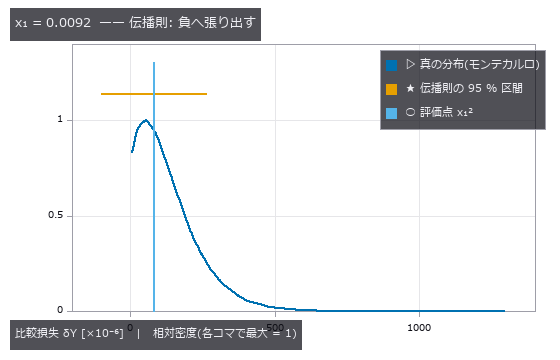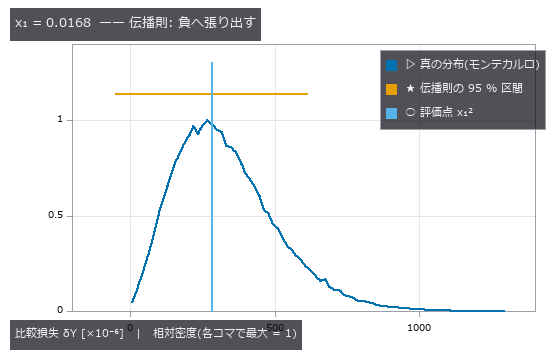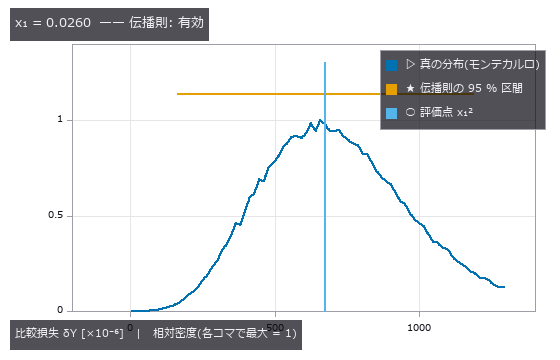
↑ 評価点 x₁ を 0 から 0.026 へ動かしたもの(乱数の種は固定)。左端では真の分布が指数で、伝播則の区間は1 点に潰れる。少し動かすと今度は区間が負の損失へ張り出す。さらに離れると真の分布が正規に近づき、両者はようやく重なる —— 3 つの段階があります。
| 評価点 | 伝播則 | モンテカルロ |
|---|---|---|
| x₁ = 0.000 | [0, 0] ← 破綻 |
[0, 149] |
| x₁ = 0.010 | [−96, +296] ← 負の損失 |
[0, 366] |
| x₁ = 0.050 | [1520, 3480] |
[1588, 3543] |
問題は、u = 0 を黙って返すと読み手が「測定が完璧だった」と受け取ることです。
例外にはしません —— 伝播則としては正しい計算だからです。警告にもしません —— 警告は握りつぶされ、ログに消えます。結果に同伴させます。
b = fs.ledger.gum_propagate({"u": [0.005, 0.005], "sensitivity": [0.0, 0.0]})
b["u_combined"]        # 0.0
b["guf_valid"]         # False
b["invalid_reasons"]   # ['stationary_point']
検出は 2 つ。感度がすべて 0 になる停留点と、区間が定義域を出る非実現区間。
後者には設計判断を 1 つ足しました。境界を渡されたときだけ検査します。 「損失だから非負」は呼ぶ側しか知らない情報で、既定で 0 を下限と仮定すると、負を取れる量(偏差・温度差)で誤検出するからです。
なおこの検出条件そのものは私の判断で、規格が列挙しているのは線形 3 条件・非線形 5 条件のほうです。実装した 2 つは、その条件が破れたときに観測される形に当たります。docstring にそう明記してあります。
5. 厳密解が、同じ「落ちた」の原因を切り分けた
規格には、モンテカルロで伝播則を検証する手続きもあります。u(y) を ndig 桁で表したときの数値許容差 δ を作り、カバレッジ区間の端点の差が両側とも δ 以下なら検証成立、というものです。
加法モデル(u = 1 の入力 4 つの和)でやってみると、正規入力でも矩形入力でも ndig = 2 は通り、ndig = 3 で落ちます。
同じ「落ちた」に見えます。ここで厳密解が効きました。
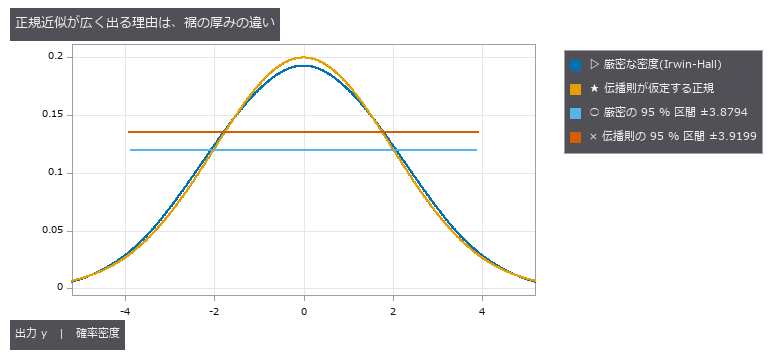
各 u = 1 の一様分布は U(−√3, √3)。その 4 つの和はスケールした Irwin–Hall(4) で、CDF は s ∈ [0,1] で F(s) = s⁴/24(F(1) = 0.0417 > 0.025 なので 2.5 % 点はこの枝にある)。反転すると
y₂.₅% = √3 (2 · 0.6^(1/4) − 4) = −3.879407
乱数を 1 つも使わない真値です。公表されている「MCM の区間 [−3.88, +3.88]」は、モンテカルロの産物ではなく厳密分位点の丸めでした。
これで切り分けられます。
| 例 | ndig=3 で落ちる理由 |
|---|---|
| 正規入力 | 伝播則は真値と厳密に一致する。落ちるのは最短区間の位置の揺れ = 推定器の問題 |
| 矩形入力 | 真の半幅は 1.939703σ なのに伝播則は正規近似の 1.959964σ を使う。差 0.040521 は δ = 0.005 の 8 倍 = 手法そのものの誤差 |
矩形のほうが構造的に広く出るのは、Irwin–Hall(4) の超過尖度が −6/(5n) = −0.3 で正規より裾が薄いからです。
そして 5 件目
「最短区間は幅が精度よく決まるのに位置が定まらない」—— これは測って分かったことですが、無条件の性質だと書いていました。
対称な分布では、幅 W(a) = F(a+w) − F(a) が中央で W' = 0 かつ曲率が小さい平らな谷になるので argmin が不安定になります。しかし歪んだ分布では最適点が一意に強く決まります。
種 12 本ずつ測った実測(位置の標準偏差 / 幅の標準偏差):
| n = 200,000 | n = 1,000,000 | |
|---|---|---|
| 対称(正規の和) | 5.2 | 4.1 |
| 歪み(二乗の和) | 1.0 | 1.0 |
docstring を「対称(または近対称)の出力に限る」に直し、機構も書きました。
6. 副産物 —— 一致率とカッパ
計数値(合否)検査の一致度も入れました。ここには古典的な罠があります。
合格率 95 % の工程では、2 人の検査員がでたらめに判を押しても素の一致率は 9 割を超えます。
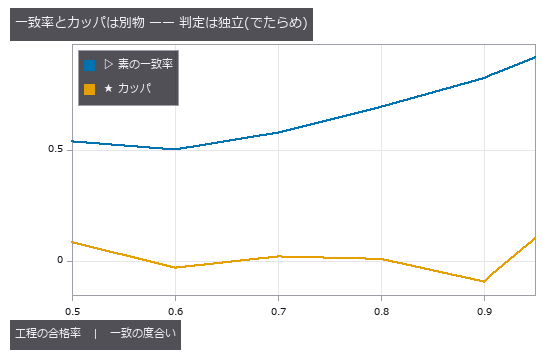
↑ 判定は完全に独立(でたらめ)。合格率が上がるほど素の一致率は上がるが、カッパは 0 付近に張り付いたまま。
実測で、合格率 0.95 のとき一致率 0.920 に対しカッパ 0.101。カッパは (p_o − p_e)/(1 − p_e) で偶然でも起きる一致を割り引いた残りを測るので、こうなります。一致率だけ見ると「よく合っている」と読めてしまう。
7. もう一つの正直さ —— 負の分散成分
分散成分は期待平均平方の差から出すので、真の成分が 0 に近いと負になります。
これは稀な端ではありません。測定者差を厳密に 0 にした合成データを種 40 本で回すと、31 本で再現性成分が負に出ました。
0 に丸めるのは妥当です。しかし丸めたことを申告しない実装は「測定者による差は無い」と言い切ります。正しくは「推定できなかった」です。
g["clamped"] # [False, True, False, False, False] ← 再現性が丸められた
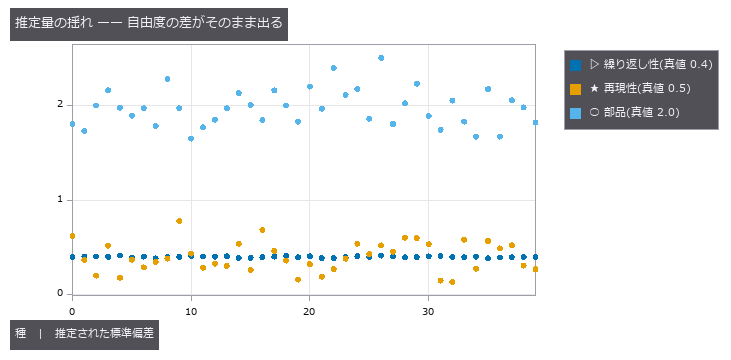
推定量の揺れも隠しません。真値 0.4 の繰り返し性は種 40 本で平均 0.39710・標準偏差 0.00788(理論 σ/√(2df) は自由度 960 で 0.00913)。一方、再現性は測定者 4 人 = 自由度 3 からの推定なので、真値 0.5 に対し標準偏差 0.159 —— 桁が合えば上等という量です。
8. 作業の進め方について
今回、一次出典の照合は別の AI に投げました。規格の PDF から worked example の生データと公表値を取ってもらい、私はそれを自分の実装に通して再現するかどうかで検証しました。
これが効いたのは、受け取った数値が正しいかどうかを独立に確かめる手段があったからです。実際:
- 生データの転記は正しかった(公表表を小数 6 桁まで再現したので、同時に証明された)
- ただしモデルが違った(交互作用のプール)—— これは数値の照合だけでは出ず、再現を試みて初めて分かった
- 相手が示した厳密解の最終桁が誤っていた(−3.8797 → 正 −3.879407)。導出の手順を示してくれていたので、閉形式・全分岐 CDF の数値反転・2×10⁷ の直接標本の 3 通りで裏を取って特定できた
- 節番号の帰属も 1 件誤っていた(適用条件は別の節)—— 条文を引き直してもらって訂正
手順を示した主張は検算できる。数値だけの主張は検算できない。 外部の情報を使うときの分かれ目はここだと思います。
9. まとめ
- 恒等式・閉形式・対照群の検査 52 件が全部緑でも、仕様の不在は映らない
- 規格の worked example は、こちらの導出と独立に印刷された答えなので、そこだけが外から差分を出せる
- 厳密解があるなら乱数を捨てる —— 同じ「落ちた」の原因が逆だと証明できたのは厳密解のおかげ
- 道具は正しく失敗するべきで、失敗は警告ではなく構造で返す
演算子は 9 つ、検査は 55 件(最終)、PoC は検査 30 件・図 14 枚(動く図 1 枚を含む)。全部 GitHub にあります。
- 能力ノート: その数字のうち、いくつが測り方のものか
- PoC:
examples/poc_measurement_system_analysis.py - 展示館: 紙面の計測館(全 143 展示)
出典
- 測定システム解析 参考マニュアル 第 4 版(分散分析法によるゲージ R&R と worked example)
- JCGM 100:2008 Evaluation of measurement data — Guide to the expression of uncertainty in measurement(伝播則、Welch–Satterthwaite、附属書 H.1 / H.2)
- JCGM 101:2008 Supplement 1 — Propagation of distributions using a Monte Carlo method(数値許容差 §7.9.2、検証手続き §8.1.3、適用条件 §5.7.2 / §5.8.1)
- B. L. Welch, Biometrika 34 (1947); F. E. Satterthwaite, Biometrics Bulletin 2 (1946)
- J. Cohen, Educational and Psychological Measurement 20 (1960); J. L. Fleiss, Psychological Bulletin 76 (1971)
- J. O. Irwin, Biometrika 19 (1927); P. Hall, Biometrika 19 (1927)