fullseye
24 コアが 1 コアに負ける ―― 行列分解の速さを、仮説ではなく測定で決めるまで
自作の画像処理ツールキット Fullseye を触っていて、 「どうもこの op が遅い」と思ったところから始まった話です。原因はアルゴリズムではありませんでした。
(この記事の図はすべて Fullseye 自身の描画 op で描いています。matplotlib は使っていません)
結論だけ先に言うと、24 論理 CPU のワークステーションで、行列分解が 1 スレッドより 3〜20 倍遅くなっていました。 そして直したあと、速さとは別に再現性まで上がりました。
ただ、この記事で本当に書きたいのはその数字ではありません。 原因を突き止める過程で、私は 4 つの仮説を出しました。そのうち 3 つが測定で折れました。 折れ方がそれぞれ違っていて、そこがいちばん面白かった。
- 「要素数で決まるのでは」→ 合計では正しい。でも採用できない
- 「メモリのパディングでは」→ 現象は実在する。でも判断は変わらない。かわりに私の実験設計の穴を暴いた
- 「メモリ配置では」→ 半分正しい。ただし手に入れる方法がない
- 「連続軸と量子化は使えないか」→ 分解には効かない。でも別の場所で 2.9 倍が出た
「思いつきを測って潰す」を 1 日ぶん通しでやった記録です。 同じことをやろうとしている人が、私と同じ穴を踏まずに済むように書きます。
なお、この記事の測定と実装は Claude Code と一緒に進めました。 仮説を出すのが私、測って潰すのがそちら、という分担です。 その分担が案外うまく機能したので、それも含めて書きます。
いそがしい人向けに 3 行
- 多コア機で SVD などの分解が 1 スレッドより 3〜20 倍遅いことがある。BLAS が
論理 CPU 数だけスレッドを立てるため。
OPENBLAS_NUM_THREADS=1を付けて速くなったら当たり - ただし行列積は逆(スレッドで速くなる)。だから絞るのは分解の周りだけ
- 直すと速さだけでなく再現性も上がる(今は機械ごとに違う下位ビットが出ている)
0. この記事で持ち帰れるもの
Fullseye を使っていない人にも効きます。numpy で SVD・固有値分解・QR・最小二乗を 呼んでいる人全員が対象です。
- 分解が遅いとき、アルゴリズムより先に疑うところ(1 行で確認できます)
- 「速くする設定」をどこに置いてはいけないか
- 実験の格子が偏っていないかを疑う方法
- 平均ではなく最悪値で判断すべき場面の見分け方
1. 用語(この記事に出てくる言葉)
先に言葉を置きます。知っている方は飛ばしてください。
用語表を開く(知っている方は飛ばして大丈夫です)
| 用語 | 読み・英語 | この記事での意味 | | --- | --- | --- | | BLAS | ビーラス(Basic Linear Algebra Subprograms) | 行列積などの基本演算を担う下請けライブラリ。numpy は自前で計算せず、これを呼ぶ | | OpenBLAS | オープンビーラス | BLAS の実装の 1 つ。PyPI の numpy に同梱されている | | LAPACK | ラパック(Linear Algebra PACKage) | SVD や固有値分解などの「分解」を担う層。内部で BLAS を呼ぶ | | GEMM | ジェム(GEneral Matrix Multiply) | 一般行列積。BLAS でいちばん最適化されている演算 | | SVD | 特異値分解(Singular Value Decomposition) | 行列を「回転・伸縮・回転」に分ける分解。低ランク近似や擬似逆行列の土台 | | 短辺 / 長辺 | ― | m 行 n 列の行列で、小さいほうと大きいほうの辺。この記事の主役は**短辺** | | leading dimension | リーディングディメンション(lda) | 行列の列と列のあいだのメモリ上の間隔。ここが 2 の冪だと事故る(後述) | | 行優先 / 列優先 | row-major / column-major | 配列をメモリに並べる向き。numpy は行優先、LAPACK は列優先 | | スレッド過剰割り当て | oversubscription | 仕事の量に対してスレッドを立てすぎて、同期の費用が計算を上回る状態 |2. かみくだき(3 段)
一言で
CPU のコアが多いマシンほど、行列分解が遅くなっていました。
もう少し
numpy が裏で使う数値計算ライブラリは、「このマシンは 24 コアあるから 24 スレッドで計算しよう」と 自動で決めます。行列の掛け算ではそれが正解です。ところが特異値分解のような「分解」では、 そのやり方が裏目に出ます。分解は内部で小さい行列積を何度も繰り返す構造をしていて、 1 回あたりの仕事が小さすぎるため、24 人で分担するとむしろ打ち合わせのほうに時間を食われる。
もうひとつ踏み込むと
しかも、スレッド数が変わると足し算の順序が変わるので、計算結果が最後の数桁で変わります。 スレッド数はコア数から自動で決まるので、何もしていない状態が、マシンごとに違う答えを出している ということになります。4 コアの CI と 24 コアの開発機で、同じコードが違う下位ビットを出していました。
つまり今回の修正は「速くする変更」であると同時に、「揺れを止める変更」でもありました。
3. 症状 ―― 高いマシンほど遅い
きっかけは、Fullseye の dc_rpca_lowrank という op でした。
ロバスト主成分分析(Robust PCA)で画像を「背景(低ランク)」と「欠陥(スパース)」に分けるものです。
中身は反復アルゴリズムで、64×64 の SVD を最大 60 回まわします。
これが、開発機(24 論理 CPU)で妙に遅い。しかも GitHub Actions(4 コア)では顕在化しない。 「性能の良いマシンだけが遅い」というのは、いかにも並列まわりの匂いがします。
まず 1 行で確かめる
疑うのは簡単です。環境変数を 1 つ付けて実行するだけ。
OPENBLAS_NUM_THREADS=1 python your_script.py
これで速くなったら当たりです。私の場合は、当たりでした。
4. 最初の測定 ―― と、その前に自分を疑う
ここで正直に書いておきたいことがあります。
最初の測定は間違っていました。
私が以前まわしっぱなしにしていた検証プロセスが 3 本、3 コアを占有した状態で測っていたのです。 その結果、48×48 の SVD で「24 スレッドは 1 スレッドの 83 倍遅い」という数字が出ました。 負荷を止めて測り直したら 27 倍でした。比率を 2〜3 倍過大に報告していたことになります。
性能測定の教訓としては当たり前の話ですが、当たり前のことほど自分がやります。
性能測定でいつも守っていること(3 点)
- 測る前に、他のプロセスが CPU を握っていないか確認する - **最小値ではなく中央値**を採る(最小値は「たまたま速かった 1 回」を拾う) - 熱の定常状態に入れる(冷えた状態のマシンは速く、それは常用の速さではない)以下の数字は、すべて負荷を止めた状態で取り直したものです。
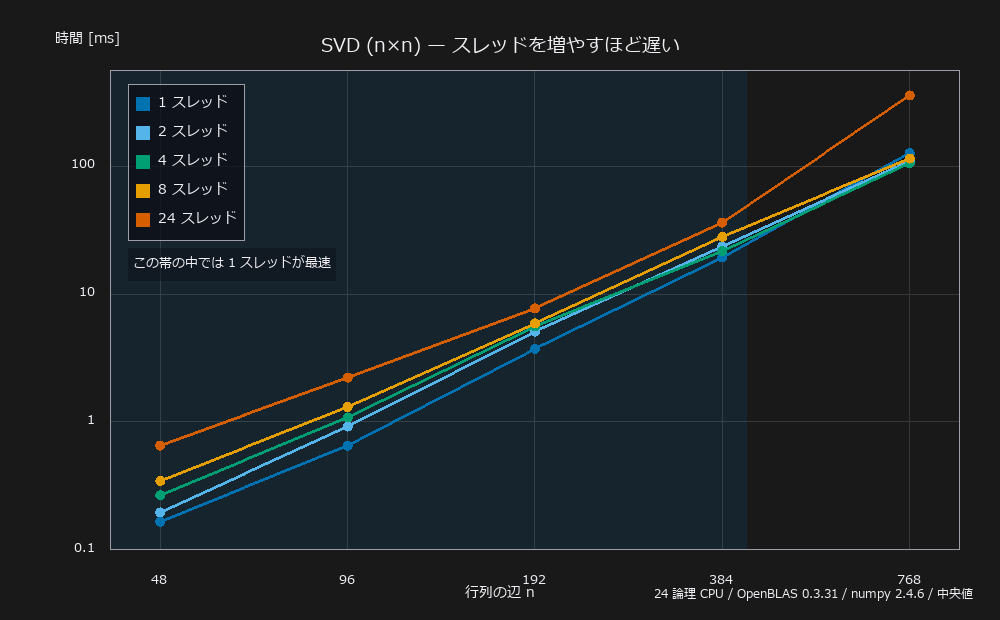
分解は、スレッドを増やしても速くならない
np.linalg.svd(n×n, full_matrices=False)、単位ミリ秒、中央値。
測定環境は 24 論理 CPU / OpenBLAS 0.3.31 / numpy 2.4.6 / Windows。
| n | 1 スレッド | 2 | 4 | 8 | 24 | 最速 |
|---|---|---|---|---|---|---|
| 16 | 0.024 | 0.024 | 0.024 | 0.024 | 0.024 | 差なし |
| 32 | 0.065 | 0.065 | 0.066 | 0.066 | 0.065 | 差なし |
| 48 | 0.165 | 0.195 | 0.266 | 0.344 | 0.651 | 1t |
| 96 | 0.650 | 0.918 | 1.081 | 1.305 | 2.217 | 1t |
| 192 | 3.721 | 5.079 | 5.576 | 5.884 | 7.727 | 1t |
| 384 | 19.331 | 23.572 | 21.686 | 28.090 | 36.243 | 1t |
| 768 | 126.939 | 109.702 | 105.845 | 115.009 | 358.628 | 4t |
48 から 384 までは、1 スレッドが最速です。24 スレッドは 2〜4 倍遅い。
固有値分解でも同じでした。192×192 の eigh は、1 スレッド 2.125 ms に対して
24 スレッドで 16.062 ms。7.6 倍です。
svd / eigh / qr / pinv の 4 種類 × 7 サイズ、合計 28 の升目を測って、 24 スレッドが勝った升目は 1 つもありませんでした。
5. では全部絞ればいい? ―― いいえ
ここが最初の分岐点です。「じゃあプロセス全体を 1 スレッドにすればいい」と思いたくなります。 それは間違いです。
同じ環境で、ただの行列積を測るとこうなります。
| n | 1 スレッド | 2 | 4 | 8 | 24 |
|---|---|---|---|---|---|
| 384 | 1.793 | 1.193 | 0.804 | 0.615 | 1.908 |
| 768 | 13.994 | 7.400 | 3.904 | 2.404 | 3.433 |
傾きが逆です。 768×768 の行列積は、8 スレッドだと 1 スレッドの 5.8 倍速い。
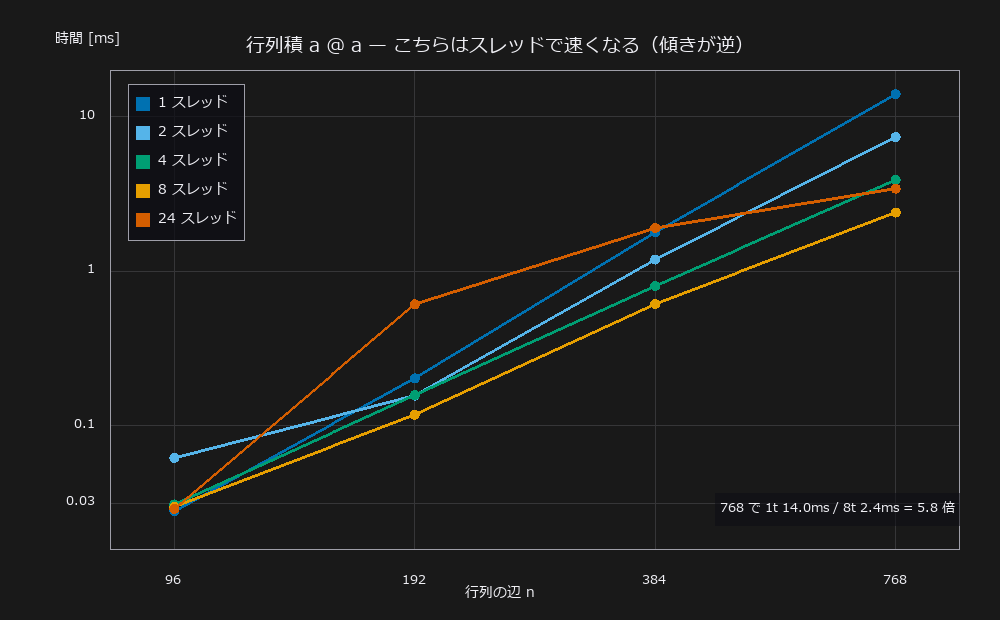
つまり同じ BLAS の中で、
- 行列積は「スレッドを増やすほど速い」
- 分解は「スレッドを増やすほど遅い」
という真逆の性質が同居しています。だから正しい対策は 「分解の周りだけ絞る」であって、プロセス全体を絞ることではありません。
6. 何を見て「絞る/絞らない」を決めるか
ここからが本題です。分解のたびにスレッド数を変えるとして、何を基準にするのか。
私が出した候補は 4 つでした。
候補 1: 要素数(行列の大きさそのもの)
いちばん素直です。「大きい行列ならスレッドを増やす、小さいなら 1 本」。
候補 2: 短辺
LAPACK の仕事量はおおよそ「長辺 × 短辺²」で、 スレッドが効くかどうかは短辺のブロック幅で決まります。
候補 3: 長辺
候補 4: 演算量そのもの(2mn² の立方根)
これを決めるために、(m, n) の格子を張って全部の升目で最速スレッド数を測り、 「その基準だけで判断したときに失う時間の合計」で採点しました。
7. 仮説が折れていく
7-1. 「要素数で決まるのでは」 ―― 合計では正しい。でも採れない
最初に確かめたのは、要素数(長辺 × 短辺)が予測子になるかどうかでした。 直感的には「データが大きいほど並列が効く」ので、悪くない仮説です。
結果はこうでした。92 升の格子(SVD と最小二乗、後述の理由で 2 の冪を外した寸法)で、 それぞれの基準で段を決めたときに失う時間です。
| 基準 | 失う時間 | 1.2 倍を超える升目 | 最悪 |
|---|---|---|---|
| 何もしない(24 スレッドのまま) | 3975 ms | 79 / 92 | 19.91 倍 |
要素数 <512:1 <1024:4 else:8 |
235 ms | 14 / 92 | 2.50 倍 |
長辺 <512:1 <1024:4 else:8 |
241 ms | ― | 3.89 倍 |
短辺 <512:1 <1024:4 else:8 |
303 ms | 5 / 92 | 1.41 倍 |
合計では要素数がいちばん良い(235 ms 対 303 ms)。仮説は当たっていました。
ところが、内訳を見ると話が変わります。要素数で決めると、92 升のうち 14 升で 1.2 倍以上損をして、 最悪の升目では 2.5 倍遅くなる。短辺なら 5 升、最悪 1.41 倍で収まる。
合計の差は 68 ms。最悪値の差は 1.41 倍と 2.50 倍。 どちらを最小化すべきか、という問題になりました。
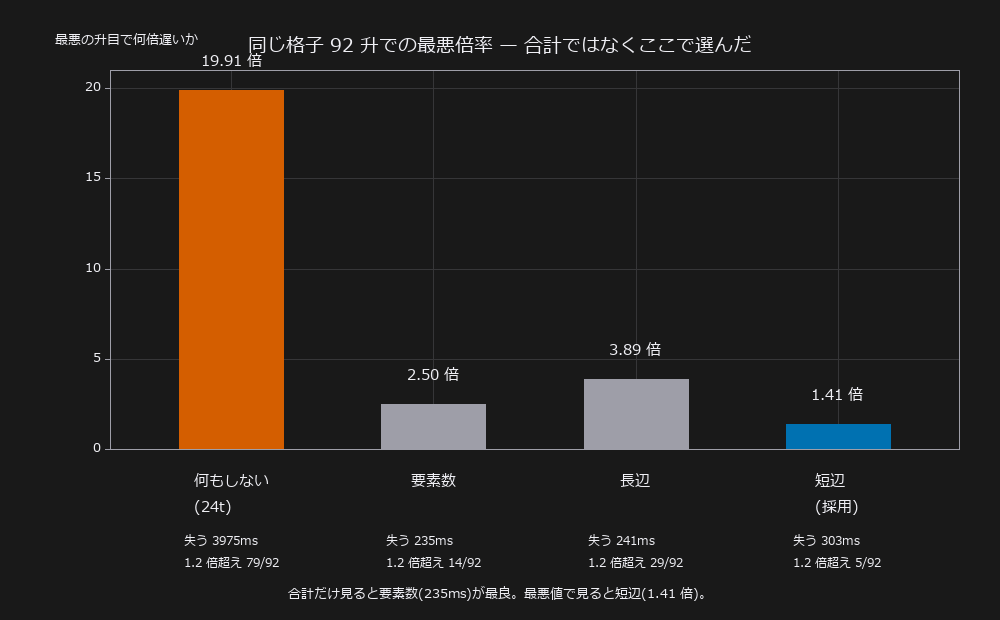
私の判断は「最悪値」です。理由は運用の話で、 平均で 1 割速いことより、最悪でも 4 割増しで済むことのほうが価値がある。 2.5 倍の後退は「遅くなった」と報告が来ますが、1.4 倍なら来ません。
ここは好みではなく、ライブラリという立場から来る判断だと思っています。 自分専用のスクリプトなら合計を採ったかもしれません。
なお長辺は、合計では要素数とほぼ同じ(241 ms)なのに、 1.2 倍を超える升目が 29 / 92、最悪 3.89 倍でした。 合計が良く見えたのは「損した升目がたまたま絶対値の小さい升目だった」からで、 合計だけ見ていたら間違えるところでした。
7-2. 「メモリのパディングでは」 ―― 現象は実在した。そして私の実験を壊した
次に出したのが、C++ の #pragma pack に相当する話です。
leading dimension が 2 の冪だと、キャッシュのセットが衝突して遅くなるのではないか。
これは密行列ライブラリではよく知られた現象で、だから BLAS は確保するときに わざと lda をずらします。測ってみました。n の前後を挟んで、単スレッドの実効性能(GFLOPS)です。
| n | 255 | 256 | 257 | 264 |
|---|---|---|---|---|
| GFLOPS | 27.9 | 26.1 | 30.4 | 30.9 |
| n | 511 | 512 | 513 | 520 |
|---|---|---|---|---|
| GFLOPS | 41.4 | 34.6 | 41.2 | 44.1 |
| n | 1023 | 1024 | 1025 | 1032 |
|---|---|---|---|---|
| GFLOPS | 43.9 | 35.9 | 44.4 | 44.5 |
2 の冪のところだけ 13〜19% 遅い。 仮説は当たりでした。 (n = 64 と 128 では差が出ません。キャッシュに収まってしまうので競合が起きない)
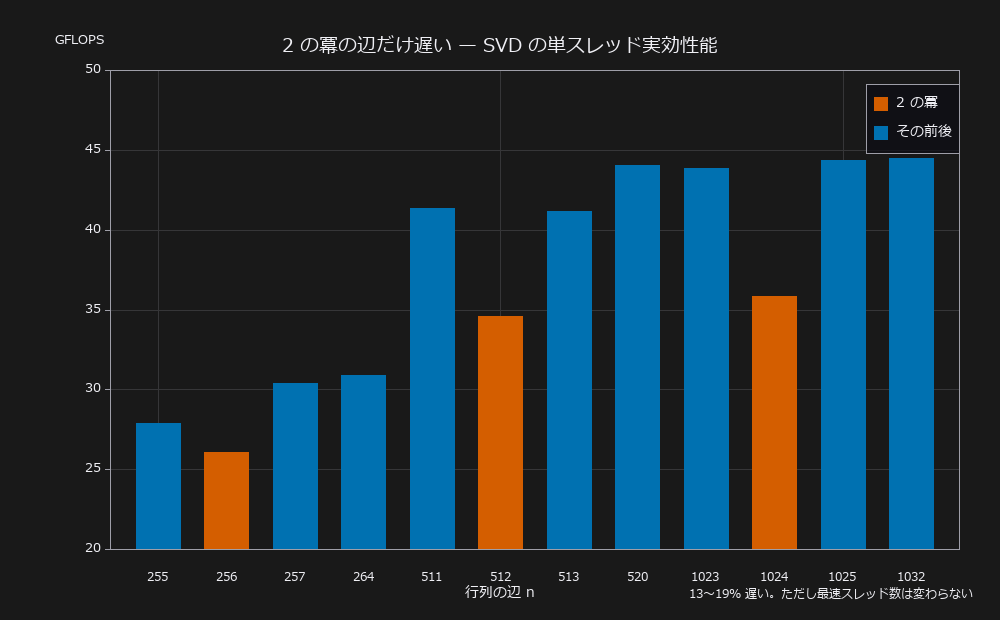
ただし、最速スレッド数は 4 つ組のどこでも同じでした。 255/256/257/264 は全部 1 スレッド、1023/1024/1025/1032 は全部 4 スレッド。 つまりこの現象は判断を変えません。
……で終わればよかったのですが、ここで嫌なことに気づきました。
私が最初に張った格子は、ほぼ全部 2 の冪でした。 32, 48, 64, 128, 256, 512, 1024 と、アスペクト比 1, 2, 4, 16, 64, 256。 つまりいちばん病的な条件だけを見て閾値を決めていたわけです。
格子を非 2 の冪(33, 48, 65, 96, 129, 192, 257, 384, 513, 768, 1025 × 1, 3, 5, 17, 65)に 張り直して測り直しました。すると結論が変わりました。
最初の格子で最良だった <1024:1 <4096:4 は、張り直した格子では 429 ms(最悪 1.43 倍)。
最良は <512:1 <1024:4 で 303 ms でした。境界が 2 つとも動いたわけです。
さらに悪いことに、最初の格子には正方 1023 のような升目が 1 つもありませんでした。
境界を 1024 に置くと n=1023 が 1 スレッドに落ちて、実測 292.78 ms 対 最速 189.83 ms、
1.54 倍の損になる。私が申告していた「最悪 1.43 倍」を超えていました。
その升目が格子に存在しなかったので、気づけなかったのです。
仮説そのものは判断を変えなかったのに、仮説を検証する過程が実験設計の穴を暴いた。 これがこの日いちばんの収穫でした。
性能を測るときは、寸法を 2 の冪から意図的に外した点を必ず混ぜる。 外さないと、遅い条件を「普通の性能」として記録するうえに、升目の分布まで偏る。
7-3. 「メモリ配置では」 ―― 半分正しい。ただし手に入れる方法がない
numpy は行優先、LAPACK は列優先です。だから分解を呼ぶたびに並べ替えが起きる。 では最初から列優先で渡せば速いのでは?
まず、すでに列優先である配列を渡すと、確かに速くなります(最小二乗、単位ミリ秒)。
| 形状 | 行優先のまま | 列優先を渡す |
|---|---|---|
| (65536, 36) | 27.4 | 17.6(0.64 倍) |
| (16384, 128) | 43.9 | 39.0(0.89 倍) |
ところが、変換の費用を含めると話が逆転します。
| 形状 | そのまま | asfortranarray してから渡す |
変換のみ |
|---|---|---|---|
| (65536, 36) | 27.4 | 26.0(0.95 倍) | 6.4 |
| (16384, 128) | 43.9 | 50.1(1.14 倍 遅い) | 8.5 |
| (4096, 512) | 414.5 | 676.5(1.63 倍 遅い) | 8.8 |
| (1024, 1024) | 172.3 | 178.6(遅い) | 3.6 |
5 形状のうち 4 つで遅くなりました。 コピーに 6〜9 ミリ秒かかるのに、節約はそれ以下だからです。
ここで次の一手を思いつきます。転置ならタダなのでは?
a.T はストライドを入れ替えるだけのビューで、C 順の (m,n) を転置すると F 順の (n,m) になります。
測ると、確かにタダでした。0.10 マイクロ秒。コピーは発生していません。
しかし、それを使って SVD を計算すると遅くなりました。
| 形状 | svd(A) そのまま |
svd(A.T) して U,V を入れ替え |
|---|---|---|
| (16384, 128) | 85.0 | 161.5(1.90 倍) |
| (4096, 512) | 1147.7 | 1276.1(1.11 倍) |
| (1024, 1024) | 760.6 | 792.8(1.04 倍) |
特異値はきちんと一致します(A = (Aᵀ)ᵀ なので数学的には正しい)。
それでも遅い。LAPACK が (n, m) の横長行列として別の経路を通るためです。
数学的に正しくても実行時間で負ける、という綺麗な例でした。
結論としては「列優先にすれば速い」は、すでに列優先である場合にだけ正しい。
自分で設計行列を組み立てている場所なら order="F" で確保するだけで縦長のとき 3 割前後取れますが、
それ以外では手を出さないほうがよい。実装は見送りました。
7-4. 「連続軸と量子化は使えないか」 ―― 分解には効かない。でも別の場所で効いた
最後の仮説です。「連続軸(行方向)が速いなら、量子化したデータを行に入れて、 データ間の演算やソートに使えるのでは」。
これは SoA(struct of arrays)配置の発想で、分解とは別の軸の最適化になります。測りました。
連続軸のソートは確かに速い(np.sort、単位ミリ秒)。
| 形状 | dtype | axis=-1(連続) | axis=0(飛び飛び) | 比 |
|---|---|---|---|---|
| (65536, 32) | float32 | 3.68 | 18.39 | 5.00 倍 |
| (4096, 256) | float32 | 1.95 | 9.12 | 4.67 倍 |
| (1024, 1024) | float64 | 5.91 | 12.27 | 2.08 倍 |
ところが量子化は、比較ソートでは逆効果でした。
(1024, 1024) の np.sort |
float64 | float32 | uint16 | uint8 |
|---|---|---|---|---|
| 時間 | 5.91 | 3.04 | 21.97 | 21.03 |
uint8 は float64 の 3.6 倍遅い。numpy の浮動小数向けソートは SIMD 最適化された経路を 通りますが、小さい整数型はそこに乗っていないためです(少なくともこの版では)。 「型を小さくすれば速い」は成り立たない。
では仮説は外れかというと、そうでもありませんでした。 利得は型ではなく「値域が有限であること」から来ます。 uint8 は 256 通りしかないので、並べ替えずに数えれば済むのです。
| uint8 の全体ソート | np.sort |
計数ソート | 倍率 |
|---|---|---|---|
| n = 16,777,216 | 355.8 ms | 66.7 ms | 5.33 倍 |
| n = 2,097,152 | 43.8 ms | 8.5 ms | 5.17 倍 |
# 計数ソート: 並べ替えではなく数える
counts = np.bincount(a, minlength=256)
sorted_a = np.repeat(np.arange(256, dtype=np.uint8), counts)

# 中央値なら展開すら要らない
c = np.cumsum(np.bincount(a, minlength=256))
median = int(np.searchsorted(c, c[-1] // 2))
中央値は 1.3〜1.7 倍でした。
自分のコードに適用先があるか数えた(結果: 無かった)
**では Fullseye に適用先はあるか。** 数えました。 2-D の全 op(881 個)を 1 回ずつ流して、並べ替えと順位統計に使われた時間の合計は **66 ミリ秒**。うち float64 が 48 ミリ秒で、整数はわずか 3.3 ミリ秒。 `axis=0` のソートは 1 件もありませんでした。 **分解の 31.4 秒とは桁が 3 つ違います。適用先がありませんでした。**ただ、心当たりを 1 つだけ潰しにいったところ、そこで当たりました。
天体写真のスタックです。K 枚のフレームを重ねて中央値を取る処理は
np.median(cube, axis=0) の形になり、これは非連続軸です。
| cube (K,H,W) | そのまま | 軸を移すだけ | partition |
軸を移して partition |
|---|---|---|---|---|
| (9, 512, 512) | 24.2 | 26.1 | 12.3 | 11.7(2.07 倍) |
| (25, 512, 512) | 80.9 | 78.5 | 66.8 | 28.2(2.87 倍) |
| (101, 256, 256) | 104.9 | 81.0 | 63.8 | 38.0(2.76 倍) |
面白いのは内訳で、枚数が少ないときは partition が効き、多いときは軸移動が効く。
LAPACK と違って別の経路に落ちないので、ここでは配置がそのまま効きます。
その後、実装しました(そして自分のテストにバグを捕まえられました)
条件は 2 つありました。`np.partition(cube,k)[k]` が中央値と等しいのは **K が奇数のときだけ**で、 偶数は中央 2 つの平均。それと NaN の扱いが `np.median` と違う (partition は NaN を末尾へ寄せるので中央の位置がずれ、**例外にならず違う値**を返す)。 実装して、`np.median` と **bitwise 一致**することをテストで固定しました。 軸を移す境目は実測で K=20(float32 も float64 も、要素数で決まりました。 バイト数=キャッシュラインで決まるという私の仮説は**外れました**)。 | cube | `np.median` | 実装後 | 倍率 | | --- | ---: | ---: | ---: | | (9, 512, 512) | 24.3 ms | 14.1 ms | 1.72 | | (25, 512, 512) | 82.0 ms | 31.9 ms | 2.57 | | (101, 256, 256) | 105.9 ms | 40.0 ms | 2.65 | そして書いたテストが、書いた直後に自分のバグを捕まえました。**uint8 で桁溢れ**していたのです。 ```python (p[k-1] + p[k]) / 2.0 # 200 + 129 -> uint8 で 73 に巻き戻る -> 36.5 # 正しくは 164.5 ``` 割り算の前に加算が巻き戻る。例外は出ません。**もっともらしく違う値**が返るだけです。 numpy と同じく `np.mean` を中央の切片に掛ける形にして直しました。 「bitwise 一致を要求する」テストにしておいたのが効きました。`allclose` で書いていたら、 128 もずれているのに気づけなかった……わけではないですが、`atol` を緩めに取っていたら 危なかったと思います。8. 決まった規則
測定を全部通した結果、こうなりました。
| 行列の短辺 | 許すスレッド数 | 根拠 |
|---|---|---|
| 32 未満 | 触らない | 絞る仕掛け自体が 2.4 マイクロ秒。それより速い分解に被せると損 |
| 32 〜 511 | 1 | この範囲で多スレッドが勝った升目が無い |
| 512 〜 1023 | 4 | 1 スレッドと拮抗し、上側で 4 が勝ち始める |
| 1024 以上 | 8 | 2048 で 8 スレッドが 1 スレッドの 2.0 倍速い。24 は全域で最悪 |
下限を 32 に置いたのにも測定の裏付けがあります。
| 下限 | 失う時間 | 最悪 | 1.2 倍超えの升目 |
|---|---|---|---|
| 32 | 303 ms | 1.41 倍 | 5 / 92 |
| 48 | 305 ms | 3.54 倍 | 9 / 92 |
| 64 | 314 ms | 3.80 倍 | 17 / 92 |
48 に置くと、合計はほとんど変わらないのに最悪が 3.54 倍に戻ります。 短辺 32〜47 の升目を素通しにするからです。
逆に下げ過ぎてもいけません。私のコードでいちばん多い分解は 3×3 の固有値分解で、 テストスイート 1 回で 247 万回(合計 10.3 秒)呼ばれています。 ここに 2.4 マイクロ秒を被せると 5.9 秒増える。短辺が 3 なので、32 なら届きません。
9. 実装 ―― 「どこに置くか」で 1.9 倍変わる
実装は Python の threadpoolctl を使いました(BSD-3、純 Python、依存ゼロ、約 40 KB)。
読み込み済みの BLAS を見つけてスレッド数を一時的に変える、移植性のある唯一の方法です。
ここで大きな罠がありました。
# これは 1 回 312 マイクロ秒かかる(毎回、読み込み済みの共有ライブラリを数え直すため)
with threadpool_limits(limits=1, user_api="blas"):
    ...

# コントローラを 1 個作って使い回すと 2.4 マイクロ秒
CTL = ThreadpoolController()
with CTL.limit(limits=1, user_api="blas"):
    ...
130 倍違います。 そして呼び出しごとに掛けると、こうなります。
| 3×3 の固有値分解を 20,000 回 | 時間 |
|---|---|
| 素のまま | 58.9 ms |
| ループの外に 1 回だけ絞る | 57.7 ms |
| 呼び出しごとに絞る | 112.9 ms(1.9 倍遅い) |
つまり「絞れば速くなる」ではなく、置き場所を間違えると絞ったせいで遅くなる。 ループの外に 1 回、が正解です。
Fullseye では fsthreads という層にまとめ、既定で有効にしました。
止めたいときは環境変数で切れます。
FULLSEYE_BLAS_THREADS=off    # 一切触らない
FULLSEYE_BLAS_THREADS=1      # 分解のあいだは常に 1
FULLSEYE_BLAS_THREADS=auto   # 既定(上の段数表)
利用者が自分の numpy コードを絞るための入口も公開しました。 ライブラリ内部の対策は利用者のコードまで届かないので、そこは自分で塞げるようにしています。
import fullseye as fs

with fs.blas_threads(1):
    U, s, Vt = np.linalg.svd(m, full_matrices=False)
置き場所をもう 1 つ間違えかけた話(ライブラリ設計の余談・読み飛ばし可)
Fullseye には `set_system` という、ライブラリ全体のふるまいを一箇所で切り替える仕組みがあります。 産業用の画像処理ライブラリによくある形で、最初は「スレッド数もそこに載せよう」と考えました。 **載せられませんでした。** あの表には制約があって、登録できるのは - 検査を**厳しくする方向にしか動かない**パラメータか、 - **数値に一切影響しない**パラメータ のどちらかだけ。しかもテストが機械で強制しています。 スレッド数は後述のとおり下位ビットを動かすので、条件を満たしません。 自分で書いた制約に自分で弾かれたわけですが、これは正しく働いたと思っています。 **速さのための設定を意味論の表に混ぜると、その表が「検査を切る設定」の入口になる。** それはいちばん避けたかったことでした。別のモジュールに置きました。10. 副産物 ―― 再現性が上がった
修正の途中で気づいたことです。スレッド数を変えると結果が変わります。
| 分解 | 1 スレッド vs 24 スレッド | 最大差 |
|---|---|---|
svd(64×64) の U, s, Vt |
bitwise 不一致 | 3.6e-16 |
svd(64×64) の特異値だけ |
一致 | 0 |
eigh(256) |
不一致 | 1.7e-12 |
qr(256) |
不一致 | 1.2e-14 |
浮動小数の足し算は順序を変えると結果が変わるので、当然といえば当然です。 スレッド数が変わると縮約の分割が変わり、順序が変わる。
問題はここからで、スレッド数は論理 CPU 数から自動で決まります。 ということは、
何もしていない状態が、マシンごとに違う答えを出している。
4 コアの CI と 24 コアの開発機で、同じコードが違う下位ビットを出していました。 「手元では通るのに CI で許容差を外れる」の原因になりうる話です。
上限を固定すると、そこが揃います。 つまり今回の修正は 「速くする(緩める)変更」ではなく「揺れを止める(締める)変更」でした。 この見方に切り替わったことで、既定で有効にする判断がしやすくなりました。
11. 「仕組みを足した」で終わらせない ―― 門を立てる
ここが個人的にいちばん大事にしている作法です。
対策を入れても、適用し忘れた場所があれば効きません。 そして「仕組みはある」で満足すると、経路のほとんどが素通しのまま緑になります。 私は以前これで痛い目を見ていて、同じ形のラッパが 24 家族あったのに 実際に通っていたのは 1 家族だけだった、ということがありました。
なので、テストを 1 本足しました。やることは単純です。
np.linalgの分解関数を一時的に包む- 全 op を実際に 1 回ずつ流す
- 上限の外で走った大きい分解を、場所ごとに数える
- 台帳(許可リスト)と両方向で突き合わせる
- 台帳に無い場所が外で分解した → 失敗(絞り忘れ)
- 台帳にあるのに一度も現れない → 失敗(消えた場所が残っている)
さらに、「何も観測しないまま緑になる」のを防ぐために、 観測できた分解の件数の下限も固定しました。 発見ゼロは頑健さの証拠ではなく、単に流れていないだけかもしれないからです。
そして門は壊して確かめました。FULLSEYE_BLAS_THREADS=off にして走らせると、
きちんと落ちて、犯人の場所まで名指しします。
AssertionError: 上限の外で大きい行列を分解している。短辺 >= 32 の分解は
fsthreads.for_decomposition(min(shape)) の中で呼ぶこと。
場所と回数: {'backends_decomp.py:_rpca': 78}
通ることを確認しただけの門は、通ることしか確認していません。
12. 結果
| 対象 | 修正前 | 修正後 | 倍率 |
|---|---|---|---|
dc_rpca_lowrank 128² |
49.8 ms | 12.3 ms | 4.04 倍 |
dc_rpca_lowrank 256² |
50.3 ms | 13.0 ms | 3.86 倍 |
dc_rpca_lowrank 512² |
60.3 ms | 21.8 ms | 2.77 倍 |
結果の差は 5.9e-15。下位ビットだけです。
なお、この op がなぜ支配的だったかというと、 テストスイート 1 回で使われる分解時間 31.4 秒のうち、 30.7 秒(98%)がこの 1 箇所だったからです。SVD の呼び出しは 23,987 回。 問題は実質 1 行に集中していました。
「どこを直せばいいか」を推測ではなく計測で出したので、
直す場所は 1 箇所で済みました。193 箇所ある np.linalg の呼び出しを
全部書き換える必要はありませんでした。
13. 今すぐ試せること
自分のコードで確かめるなら、この順です。上ほど効きやすく、確認が安い。
- スレッド数 ――
OPENBLAS_NUM_THREADS=1を付けて速くなるか(1 行、数秒) - 行列の大きさと形 ―― 短辺はいくつか。縦長か正方か
- 呼び出し回数 ―― 1 回が遅いのか、小さいのを何万回も呼んでいるのか
- 寸法が 2 の冪か ―― ベンチマークの寸法が偏っていないか
- メモリ配置 ―― ここまで来て初めて。しかも変換する価値は薄い
現状を確かめるだけなら、これで出ます。
from threadpoolctl import threadpool_info
for d in threadpool_info():
    print(d["user_api"], d["internal_api"], d["num_threads"])
Fullseye を使っている方は、pip install -U fullseye すれば既定で効きます。
判断の根拠と実測は、パッケージ内のドキュメント
(docs/ops/math/guides/blas_threads_and_memory.md)に症状→原因の診断表つきで入れました。
実際に測って印字するサンプルも同梱しています。
py -3.11 examples/blas_thread_budget.py
倍率は機械で変わるので、このサンプルは速さを assert しません。 判定するのは「上限の有無で結果が一致すること」だけで、速さは測って印字するだけにしてあります。 閾値で判定すると、別のマシンで意味なく落ちるからです。
14. おわりに ―― 仮説を出す人と、潰す人
この記事の測定と実装は Claude Code と一緒に進めました。 振り返ると、役割が自然に分かれていました。
- 仮説を出すのは人間の側でした。要素数、パディング、メモリ配置、量子化と連続軸。 4 つとも私が思いついたもので、どれも「言われてみればありそう」な筋です。
- 潰すのは機械の側でした。1 つの仮説につき格子を張って測り直す作業は、 正直なところ人間がやると途中で飽きます。
そして重要なのは、折れた仮説にも仕事があったことです。 パディングの仮説は判断を変えませんでしたが、私の実験格子が 2 の冪だらけだという偏りを暴きました。 それがなければ、最悪 1.54 倍の升目を見落としたまま「最悪 1.43 倍」と報告していたはずです。
「思いつきを言う」ことの価値は、当たることではなく、測る対象が増えることにあるのだと思います。 外れた仮説を測るコストが下がった今、思いつきは前より安くなりました。
次回に続く
今回は 1 つの症状を深掘りしましたが、Fullseye 側では他にも直したことがあります。
- 配布した wheel から 224 個の op(26%)が消えていた話
- チェックポイントを開くだけで任意コードが動く穴を塞いだ話
- Linux で初めて動かしたら、日本語ラベルが全部同じ豆腐になっていた話
- 門を「正しい場所」に立てても、入力が 1 つだと見逃す話
どれも「テストは緑だったのに壊れていた」という同じ形をしています。 次回はそちらをまとめます。
そして今回の宿題が 1 つ残っています。
- 混合精度の反復改良 ―― float32 で分解して float64 で残差を戻す古典
(LAPACK に
dsgesvとして入っています)。今回の分解まわりにそのまま 乗る可能性がありますが、まだ測っていません
(天体スタックの中央値はこの記事を書いているあいだに実装しました。上の 折りたたみに顛末を入れてあります)
測ってから書きます。
Fullseye は Apache-2.0 で公開しています。 リポジトリ: https://github.com/furuse-kazufumi/fullseye この記事の数値はすべて 24 論理 CPU / OpenBLAS 0.3.31 / numpy 2.4.6 / Windows で、 他の負荷を止めた状態の中央値です。他のマシンでは数字が変わりますが、傾きの向きは再現するはずです。